Grok MCP: tool per immagini e video nell’API di xAI
Collega un server MCP remoto a Grok tramite l’API di xAI o un connettore personalizzato di grok.com e fai generare a Grok immagini, video e voce. Config reale, tracce 401, da $0.03.

I tool MCP remoti in Grok sono una funzione lato server dell’API di xAI: indichi un server MCP dentro l’array tools di una richiesta, e il runtime di xAI apre la connessione, legge l’elenco dei tool e li chiama mentre Grok scrive la risposta. Sul tuo portatile non gira niente. È tutta qui la differenza rispetto a Cursor o Claude Code, dove il client MCP sta nell’editor davanti a te e a parlare è la tua macchina.
Risposta rapida: aggiungi un oggetto a tools — {"type": "mcp", "server_url": "https://bananabanana.pro/api/mcp", "server_label": "bananabanana", "authorization": "Bearer bb_live_…"} — e Grok ottiene dieci tool di generazione: immagini con la famiglia Nano Banana, video con Veo 3.1 e Gemini Omni Flash, voce con Gemini TTS. Le immagini partono da $0.03, i video da $0.10, e un account nuovo ha $0.20 per provare. Su grok.com lo stesso URL va in Connectors → New Connector → Custom, anche se la parte di accesso di quella strada è meno assodata (più sotto c’è una sezione dedicata).
Tutto ciò che riguarda il nostro lato della connessione è stato misurato con richieste reali il 1° settembre 2026. Tutto ciò che riguarda il lato di xAI viene dalla loro documentazione così com’era quel giorno, e la cito invece di parafrasarla, perché questa parte della loro API cambia spesso.
Due superfici, un solo server
«Grok supporta MCP?» in realtà sono due domande, con risposte diverse.
| Superficie | Cosa documenta xAI | Dove gira il client MCP |
|---|---|---|
| API di xAI | I tool MCP remoti funzionano in "the xAI native SDK, the OpenAI compatible Responses API, and the Speech to Speech API" | Server di xAI |
| grok.com | Connectors → New Connector → Custom: "Enter the MCP server URL and complete any required authentication" | Server di xAI |
| Grok dentro un IDE | non trattato da nessuna delle due pagine | sconosciuto |
Due vincoli della stessa pagina meritano una seconda lettura. I trasporti: "Only Streaming HTTP and SSE transports are supported." E la strada compatibile con OpenAI perde due parametri, require_approval e connector_id, quindi lì un cancello di approvazione prima di una chiamata a un tool a pagamento non puoi chiederlo a xAI. Lo costruisci tu, oppure scegli con cura i tool.
Il nostro endpoint è Streamable HTTP senza stato, il trasporto che supera quell’asticella. Nessun header di sessione da tenere vivo, nessuno stream SSE da sorvegliare, una risposta JSON per ogni richiesta JSON-RPC.
Collegare BananaBanana all’API di xAI
La cosa più piccola che funziona, cURL diretto contro la Responses API:
curl https://api.x.ai/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -d '{
    "model": "grok-4.6",
    "input": [
      { "role": "user",
        "content": "Generate a 16:9 product photo of a ceramic cup on linen, soft morning light. Use nano-banana-pro, then give me the URL." }
    ],
    "tools": [
      {
        "type": "mcp",
        "server_url": "https://bananabanana.pro/api/mcp",
        "server_label": "bananabanana",
        "server_description": "Image, video and speech generation on Google models",
        "authorization": "Bearer bb_live_your_key_here",
        "allowed_tools": ["list_models", "generate_image", "get_result"]
      }
    ]
  }'
La stessa cosa con l’SDK Python di xAI, dove cambiano i nomi di due parametri:
from xai_sdk import Client
from xai_sdk.chat import user
from xai_sdk.tools import mcp

client = Client(api_key=os.environ["XAI_API_KEY"])

chat = client.chat.create(
    model="grok-4.6",
    tools=[
        mcp(
            server_url="https://bananabanana.pro/api/mcp",
            server_label="bananabanana",
            authorization=os.environ["BB_KEY"],          # extra_headers=… also works
            allowed_tool_names=["list_models", "generate_image", "get_result"],
        )
    ],
)
chat.append(user("Make me a 16:9 hero image of a ceramic cup on linen."))
Prendi una chiave bb_live_… dal tuo profilo, nella sezione Chiavi API MCP. Viene mostrata una sola volta.
Due dettagli costano a ognuno un pomeriggio.
Il prefisso Bearer. xAI descrive authorization come "a token that will be set in the Authorization header on requests to the MCP server", il che lascia aperto se il valore lo incapsulano loro in Bearer. Il nostro server non tira a indovinare. Mandi un token nudo e ti torna indietro un reclamo preciso:
{"error":{"code":-32001,"message":"Unsupported Authorization scheme. Use 'Authorization: Bearer <token>'."}}Quindi lo schema scrivilo tu: "authorization": "Bearer bb_live_…". Se un giorno lato xAI finisse incapsulato due volte, usa la forma senza ambiguità e imposta l’header direttamente con headers: {"Authorization": "Bearer bb_live_…"}.
allowed_tools non è facoltativo, nella sostanza. La documentazione di xAI è netta: senza, ogni definizione di tool esposta dal server finisce nel contesto del modello: "if an MCP server exposes 10 different tools and you don't specify allowed_tools, all 10 tool definitions will be available." Noi ne esponiamo esattamente dieci. Metà spendono soldi. Per un bot di immagini consentirei list_models, generate_image e get_result e nient’altro, poi allargherei quando vuoi davvero i video.
Cosa vede Grok quando bussa
Ecco il nostro handshake, eseguito per questo articolo. La scoperta dei tool non richiede alcuna credenziale:
curl -s -X POST https://bananabanana.pro/api/mcp \
  -H "Content-Type: application/json" \
  -d '{"jsonrpc":"2.0","id":1,"method":"tools/list"}'
list_models, get_account, top_up, generate_image, edit_image,
generate_video, edit_video, generate_speech, get_result, list_generations
Tutto ciò che fa davvero qualcosa risponde 401 finché non presenti un token, e la risposta porta l’indicazione di cui un client fatto bene ha bisogno:
HTTP/2 401
www-authenticate: Bearer realm="bananabanana",
  error_description="Authentication required. Connect this server with OAuth,
  or create an API key at https://bananabanana.pro/profile",
  resource_metadata="https://bananabanana.pro/.well-known/oauth-protected-resource/api/mcp",
  scope="mcp"
Quell’URL resource_metadata restituisce il documento di protected resource metadata della specifica di autorizzazione MCP, ed è così che i client capaci di OAuth trovano da soli il nostro server di autorizzazione. Sulla strada dell’API di xAI il 401 non lo incontrerai mai, perché la tua chiave viaggia con ogni chiamata. Conta per la storia del connettore più sotto.
Un’altra nota di compatibilità, perché morde chi si scrive il client a mano: non pretendiamo un header Accept: application/json, text/event-stream e rispondiamo in JSON semplice. I server che insistono sull’header Accept in stile SSE sono quelli che falliscono misteriosamente dietro i gateway.
Preventivo, job, polling: il flusso che spiazza gli agenti
Generare un’immagine è una chiamata e un’attesa. Un video no, ed è qui che un ciclo d’agente scritto per «chiama il tool, leggi la risposta» si inceppa.
Le richieste video e multi-immagine tornano con un preventivo invece che con un job. Il modello deve chiamare il tool una seconda volta con confirm_cost impostato esattamente su quel numero, al centesimo, prima che venga addebitato qualcosa. È un dosso voluto: un agente non deve poter spendere $4.40 in una clip Veo in 4K perché qualcuno ha scritto «rendilo cinematografico».
Poi la generazione è asincrona. generate_image e generate_video restituiscono subito un job_id; get_result fa long-polling fino a 30 secondi per chiamata e lo richiami finché lo stato non si stabilizza. Le immagini di solito arrivano in 10–60 secondi. I video richiedono da 1 a 10 minuti a seconda del modello e della durata.
Conseguenza pratica per la Responses API: un solo turno dell’utente può richiedere quattro o cinque chiamate di tool lato server, e se la tua integrazione limita i passaggi dei tool a due, Grok riporterà un job_id e si fermerà come un cameriere che prende l’ordine e se ne va a casa. Dagli spazio. Passa anche idempotency_key nelle chiamate di generazione, così una richiesta ripetuta non produce un secondo addebito.
I fallimenti si rimborsano da soli. Se il filtro dei contenuti di Google rifiuta un prompt o una chiamata a monte muore, il saldo torna indietro automaticamente e get_result spiega quale fase l’ha rifiutato. Non paghi mai un video che non hai ricevuto.
Si può fare anche su grok.com?
In parte, e la risposta onesta ha un buco.
xAI documenta chiaramente la strada: vai su grok.com/connectors, clicca New Connector, scegli Custom, poi "Enter the MCP server URL and complete any required authentication." Il server dev’essere raggiungibile da internet pubblico, e il nostro ovviamente lo è. I connettori integrati, dice la pagina, si autenticano ciascuno via OAuth.
Quello che la pagina non dice è quali metodi di autenticazione accetta un connettore personalizzato. Quell’unica frase, "complete any required authentication", è l’intera specifica, ed è stata aggiornata l’ultima volta il 17 luglio 2026.
Ecco a che punto siamo. Facciamo girare un server di autorizzazione OAuth 2.1 completo: registrazione dinamica dei client, PKCE con S256, protected resource metadata, resource indicators, l’intera specifica di autorizzazione MCP. Qualsiasi client che segue quella specifica si collega a noi senza una sola riga di lavoro da parte nostra, ed è esattamente così che fanno i connettori di Claude e ChatGPT. Se il connettore personalizzato di Grok percorre lo stesso flusso, funzionerà e basta, e vedrai una normale pagina di accesso con il nome del tuo account.
Se invece salva solo un URL e non manda credenziali, vedrai comparire tutti e dieci i tool nell’elenco del connettore e ogni singola chiamata tornerà con 401. Sul nostro server la scoperta dei tool è anonima, quindi un connettore può sembrare in salute e non riuscire a generare niente.
Mi piacerebbe essere più preciso. Se l’hai provato, il risultato merita una mail a [email protected], e la tabella di compatibilità sulla nostra pagina MCP viene aggiornata in giornata.
Quanto costa
I prezzi sono per generazione, addebitati da un saldo prepagato, senza abbonamento.
| Cosa | Modello | Prezzo |
|---|---|---|
| Immagine, 1K | Nano Banana 2 Lite | $0.03 |
| Immagine, 512–4K | Nano Banana 2 | $0.03–$0.13 |
| Immagine, 1K–4K | Nano Banana Pro | $0.11–$0.20 |
| Video, 4 s 720p senza audio | Veo 3.1 Lite | $0.10 |
| Video, da | Veo 3.1 Fast | $0.35 |
| Video, da | Veo 3.1 | $0.70 |
| Video con audio, al secondo | Gemini Omni Flash | $0.10 ($0.30 per il minimo di 3 s) |
| Voce | Gemini 3.1 Flash TTS | $0.01 ogni 200 caratteri |
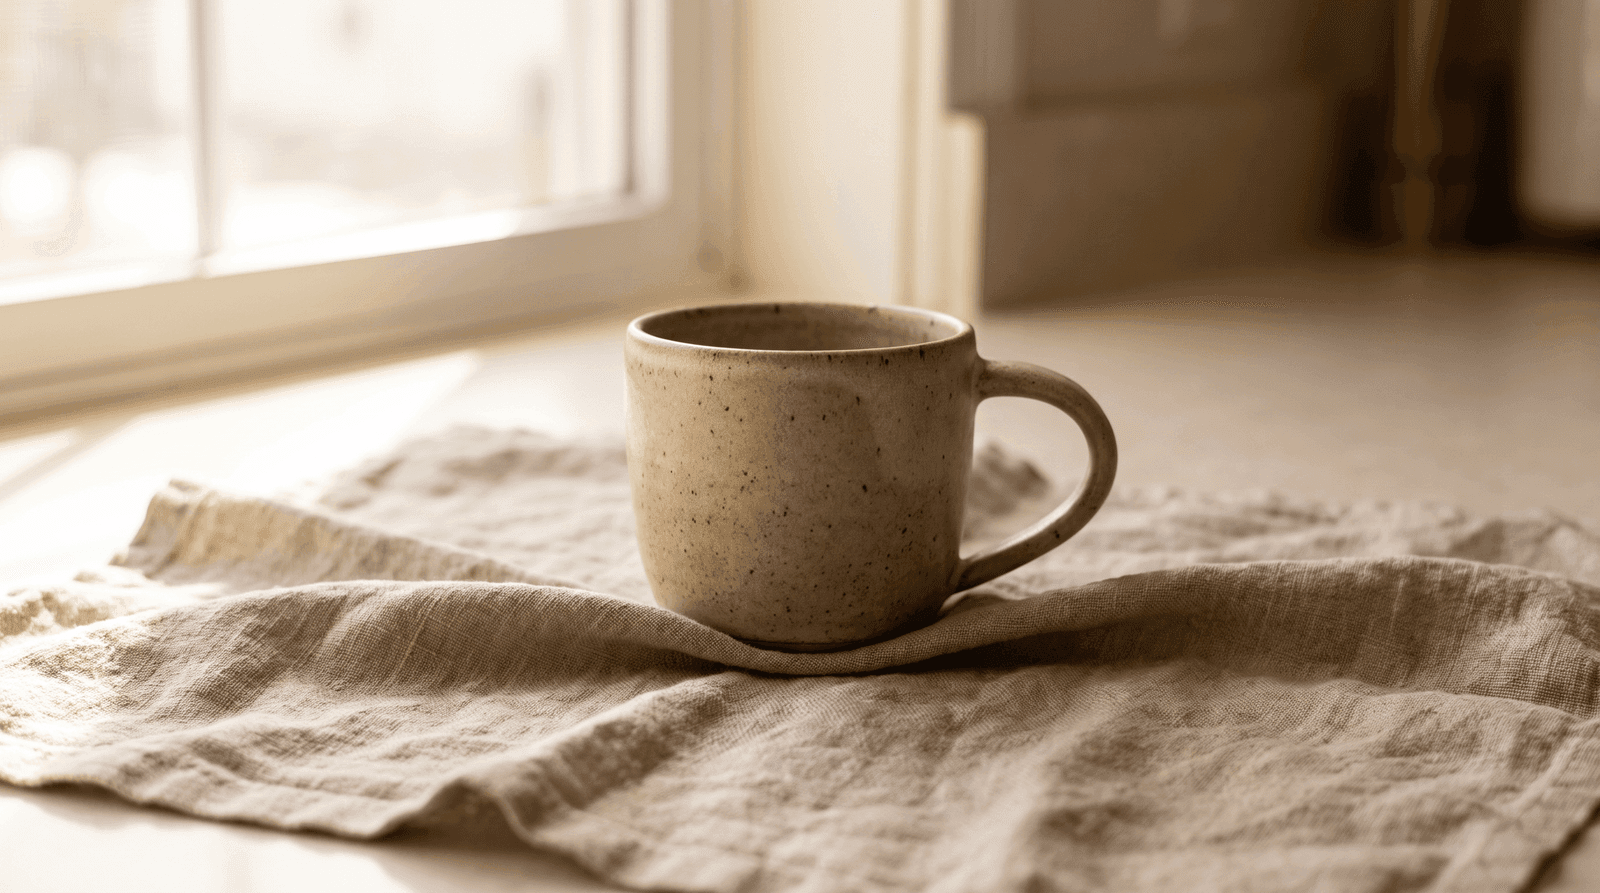
Quella tazza è il prompt dell’esempio cURL più sopra, eseguito davvero mentre scrivevo: Nano Banana Pro a 2K, addebitati $0.11, finita 32 secondi dopo la chiamata al tool.
Un account nuovo parte con $0.20, che bastano per sei immagini Lite o una breve clip Veo Lite. Abbastanza per verificare il collegamento, non per giudicare i modelli buoni, e preferisco dirlo chiaramente piuttosto che far finta di niente.
Le ricariche aggiungono un bonus a volume: 5% da $50, 10% da $100. Un codice promo attivo aggiunge un altro 10% del deposito, calcolato sulla stessa base, quindi $100 con un codice accreditano $120. I numeri aggiornati sono sempre nella sezione prezzi.
Grok fa già immagini. Perché passare da un’altra parte?
Domanda giusta, e metà della risposta la dà l’elenco modelli di xAI stessa: offrono grok-imagine-image-2.0 e grok-imagine-video-1.5. Per un’immagine veloce dentro una chat, usa quelli. Nessuno ha bisogno di un server MCP per questo.
I motivi per mandare la generazione da noi sono più specifici, e riguardano soprattutto quali modelli e come si legge la fatturazione:
- Modelli Google specifici. Nano Banana Pro per il testo nelle immagini e il lavoro sui prodotti, Veo 3.1 per video con audio nativo, Omni Flash quando vuoi l’audio e un passaggio di modifica conversazionale sulla stessa clip.
- Un prezzo prima dell’addebito.
list_modelsrestituisce i prezzi unitari aggiornati, e i video fanno un preventivo prima di spendere. A un agente puoi dire di restare sotto un budget, e lo rispetterà davvero. - Un solo saldo per tutti i client. La stessa chiave funziona da Grok, Gemini CLI, Codex e dallo Studio web, e ogni risultato finisce in un’unica cronologia.
- Rimborsi in caso di errore, che contano più di quanto sembri quando nel ciclo c’è un filtro dei contenuti.
I costi onesti di questa strada: un salto di rete in più e un ciclo di polling, video che richiedono un passaggio di conferma, 1080p e 4K di Omni Flash che arrivano tramite upscale e non con rendering nativo, e schemi dei tool che i client mettono in cache al momento della connessione, per cui un nuovo parametro da parte nostra richiede di ricollegarti prima che Grok possa passarlo. Niente di tutto questo è fatale. Tutto è reale.
FAQ
Grok supporta i server MCP?
Sì, lato API. I Remote MCP Tools di xAI funzionano nell’SDK nativo, nella Responses API compatibile con OpenAI e nella Speech to Speech API, con server_url e server_label obbligatori e authorization, headers e allowed_tools facoltativi. Su grok.com i connettori MCP personalizzati esistono in Connectors → New Connector → Custom.
Mi serve OAuth o basta una chiave API?
Per l’API di xAI basta una chiave bb_live_…, ed è più semplice: passala come authorization includendo il prefisso Bearer. OAuth conta per i client in stile connettore che fanno accedere gli utenti da soli. Il nostro server supporta entrambi sullo stesso endpoint.
Quale modello Grok dovrei usare?
Gli esempi MCP di xAI usano grok-4.6, al momento la loro raccomandazione predefinita. Va bene qualsiasi modello che supporti i tool lato server; il contratto dei tool non cambia tra l’uno e l’altro.
Grok può generare video con audio in questo modo?
Sì, tramite Veo 3.1 con audio o Gemini Omni Flash, che produce sempre l’audio. Aspettati la conferma in due passaggi e un polling di un minuto o più. La risoluzione nativa di Omni è 720p, con 1080p e 4K che arrivano da un passaggio di upscale, quindi una clip hero a schermo intero potrebbe comunque risultare più nitida con Veo.
Cosa succede quando una generazione fallisce?
L’addebito si annulla automaticamente e get_result restituisce il motivo a monte più un suggerimento sul passo successivo. Vale la pena ritentare i rifiuti del filtro dei contenuti con parole diverse; lo stesso prompt può passare al secondo tentativo, perché il filtro giudica i pixel prodotti, non solo la richiesta.