AI Image to Video: Ubah Foto Menjadi Video Bergerak
Cara kerja AI image to video, pilihan model (Veo 3.1, Omni Flash, Wan 3.0, Grok), harga riil mulai $0.10 per klip, motion prompt, loop, rantai 148 detik.

AI image to video adalah teknik generasi di mana model AI mengambil satu foto diam, menjadikannya bingkai (frame) pertama, lalu "mengarang" semua kelanjutannya: gerakan objek, pergerakan kamera, perubahan cahaya, bahkan terkadang suara. Anda cukup mengunggah foto dan menulis deskripsi teks tentang bagian apa yang harus bergerak. Model akan menghasilkan video pendek, biasanya berdurasi 4 hingga 10 detik, yang membuat foto Anda tampak hidup.
Versi singkatnya jika Anda sedang buru-buru: unggah foto di generator BananaBanana, jelaskan gerakannya, lalu tunggu sekitar 2–5 menit. Klip tanpa suara berdurasi 4 detik dari foto Anda dihargai mulai dari $0.10 menggunakan Veo 3.1 Lite, sedangkan opsi dengan suara menjadi $0.18. Gemini Omni Flash menganimasikan foto lengkap dengan suara mulai dari $0.09 (ditagih per detik, $0.03 di 360p hingga $0.30 di 4K), dan Wan 3.0 melakukannya dengan suara gratis mulai $0.20 untuk 4 detik di 480p. Akun baru langsung mendapatkan saldo gratis $0.20, cukup untuk mencoba dua klip tanpa suara.
Kami menjalankan tujuh model video di server produksi kami, dan semuanya menerima foto sebagai frame pertama, jadi panduan ini membahas ketujuhnya, ditulis berdasarkan log pembuatan video yang asli, bukan sekadar klaim pemasaran. Kami juga menyertakan kegagalannya—karena terkadang melihat hasil yang gagal justru lebih mencerahkan daripada yang langsung berhasil.
Bagaimana cara kerja AI image to video?
Di balik layar, gambar diam Anda dikirim ke model sebagai bingkai pengondisi (conditioning frame). Dokumentasi resmi Gemini API video docs milik Google menjelaskan bahwa Veo 3.1 mendukung "image-based direction" dan "frame-specific generation". Sederhananya, foto Anda mengontrol arah seluruh klip, dan Anda bisa menentukan letak frame yang tepat. Model AI akan membaca elemen gambar, memprediksi hukum fisika di dalamnya (bagaimana air di foto Anda harus beriak, atau bagaimana rambut berkibar tertiup angin), lalu merender bingkai demi bingkai ke depan dari titik awal tersebut.
Hasil praktisnya: frame pertama dari video yang dihasilkan adalah foto Anda, hampir persis piksel demi piksel. Segala sesuatu setelahnya adalah murni hasil rekaan AI. Makanya, prompt yang bagus berfokus pada apa yang ingin Anda tambahkan atau gerakkan, bukan mendeskripsikan ulang objek yang sudah terlihat jelas di foto.
Metode ini bekerja sangat luar biasa pada foto yang memiliki potensi gerakan alami. Misalnya, potret wajah yang bernapas dan berkedip, uap mengepul dari secangkir kopi, atau mobil terparkir yang mulai melaju. Namun, hasilnya kurang oke kalau fotonya sama sekali tidak menunjukkan potensi gerakan: jika Anda memasukkan render produk statis dengan latar belakang putih tanpa instruksi gerakan di prompt-nya, biasanya Anda hanya akan mendapatkan efek zoom lambat yang agak kaku. Videonya tidak rusak, cuma membosankan.
Model mana yang paling bagus untuk mengubah foto menjadi video?
Ketujuh model video di platform kami dapat menerima gambar sebagai frame pertama. Bedanya ada pada kualitas batas atas (ceiling) serta biaya yang Anda keluarkan. Model Google lebih dulu:
| Veo 3.1 | Veo 3.1 Fast | Veo 3.1 Lite | Gemini Omni Flash | |
|---|---|---|---|---|
| Harga (4 detik, tanpa suara) | $0.70 | $0.35 | $0.10 | — |
| Harga (4 detik, dengan suara) | $1.50 | $0.50 | $0.18 | $0.12 di 360p, $0.40 di 720p |
| Resolusi maks | 4K | 4K | 1080p | 4K (upscaled) |
| Durasi | tepat 4/6/7/8 detik | tepat 4/6/7/8 detik | tepat 4/6/7/8 detik | tepat 3–10 detik |
| Audio | tombol opsional | tombol opsional | tombol opsional | selalu aktif |
| Frame terakhir + loop | ya | ya | ya | ya (Omni 1.1) |
| Perpanjangan | hingga 148 detik | hingga 148 detik | tidak | hingga 40 detik, plus pengeditan video |
Pilihan andalan saya adalah Veo 3.1 Fast. Model ini mempertahankan kontrol penting (durasi presisi, opsi frame terakhir, perpanjangan durasi) dengan setengah harga model flagship. Untuk konsumsi media sosial, perbedaan kualitasnya dengan versi penuh Veo 3.1 hampir tidak kentara. Opsi Lite seharga $0.10 biasanya saya pakai untuk menguji apakah sebuah ide gerakan layak diproduksi atau tidak sebelum mengeluarkan biaya lebih banyak. Versi penuh Veo 3.1 baru terasa sebanding dengan harganya jika video Anda melibatkan elemen air, kain, tabrakan, atau jika format akhirnya mewajibkan resolusi 4K. Sedangkan Omni Flash sangat cocok jika kualitas audio sama pentingnya dengan visual; kami mengupasnya secara mendalam di ulasan API Omni Flash terpisah jika Anda ingin tahu detailnya, termasuk cara harga per detiknya berjenjang mulai dari 360p hingga 4K. Generasi Omni sebelumnya, Omni Flash 1.0, masih bisa dipilih dengan durasi 4 hingga 10 detik dan hanya menerima frame pertama.
Klip di atas merupakan hasil buatan Veo 3.1 Fast langsung dari pipeline produksi kami yang dibuat khusus untuk artikel ini: sebuah bingkai foto kapal layar di atas meja kerja, lalu prompt meminta air laut di dalam bingkai tersebut mulai bergerak perlahan saat kamera mendekat. Sekali coba, tanpa edit, dan sengaja dibuat tanpa suara (paket tanpa suara dari Fast adalah pilihan kami untuk uji coba draf). Efek "foto yang menjadi hidup" ini adalah gambaran umum dari apa yang dilakukan model AI terhadap foto yang Anda unggah.
Lalu dua model yang bergabung pada September, dari Alibaba dan xAI:
| Wan 3.0 | Grok Imagine Video 1.5 | |
|---|---|---|
| Harga (4 detik, dengan suara) | $0.20 di 480p, $0.40 di 720p, $0.80 di 1080p | $0.56 di 720p |
| Resolusi maks | 1080p | 1080p (gambar referensi hanya di 720p) |
| Durasi | 4, 6, 8, 10, 15, 20, atau 30 detik | bilangan bulat apa pun dari 4 hingga 15 detik |
| Audio | aktif secara default dan gratis, bisa dimatikan | selalu aktif, dialog lip-sync |
| Frame terakhir + loop | ya | tidak |
| Perpanjangan | tidak, tapi 30 detik dalam satu take | tidak |
Wan 3.0 adalah model yang saya pilih untuk sebuah foto saat klipnya harus lebih dari sepuluh detik atau harus bersuara tanpa biaya tambahan. Grok untuk foto seseorang yang kemudian harus mengucapkan sesuatu: tulis kalimatnya dalam tanda kutip dan gerak mulutnya akan mengikuti. Foto balon yang sama (render Nano Banana Pro, jadi tidak melibatkan wajah siapa pun) di kedua model, dengan prompt yang sama: balon yang tertambat naik sedikit sementara pembakarnya menyala dan kabut melayang:
Wan 3.0, enam detik di 720p, $0.60. Ia mempertahankan foto nyaris piksel demi piksel, mengangkat balon beberapa meter, memperlihatkan tali tambat yang tidak ada di foto diamnya, dan menaruh semburan pembakar singkat serta kicau burung di trek audio tanpa perlu diminta dua kali.
Grok Imagine Video 1.5, enam detik di 720p, $0.84. Gerakannya lebih halus, kesetiaan pada sumber sama, dan satu detail dari log yang perlu diketahui: filenya kembali dalam 1280×704, bukan 720 baris sungguhan. Tidak masalah untuk feed, merepotkan kalau Anda sedang compositing.
Cara mengubah foto menjadi video, langkah demi langkah
Seluruh proses di generator hanya membutuhkan waktu sekitar satu menit ditambah waktu render.
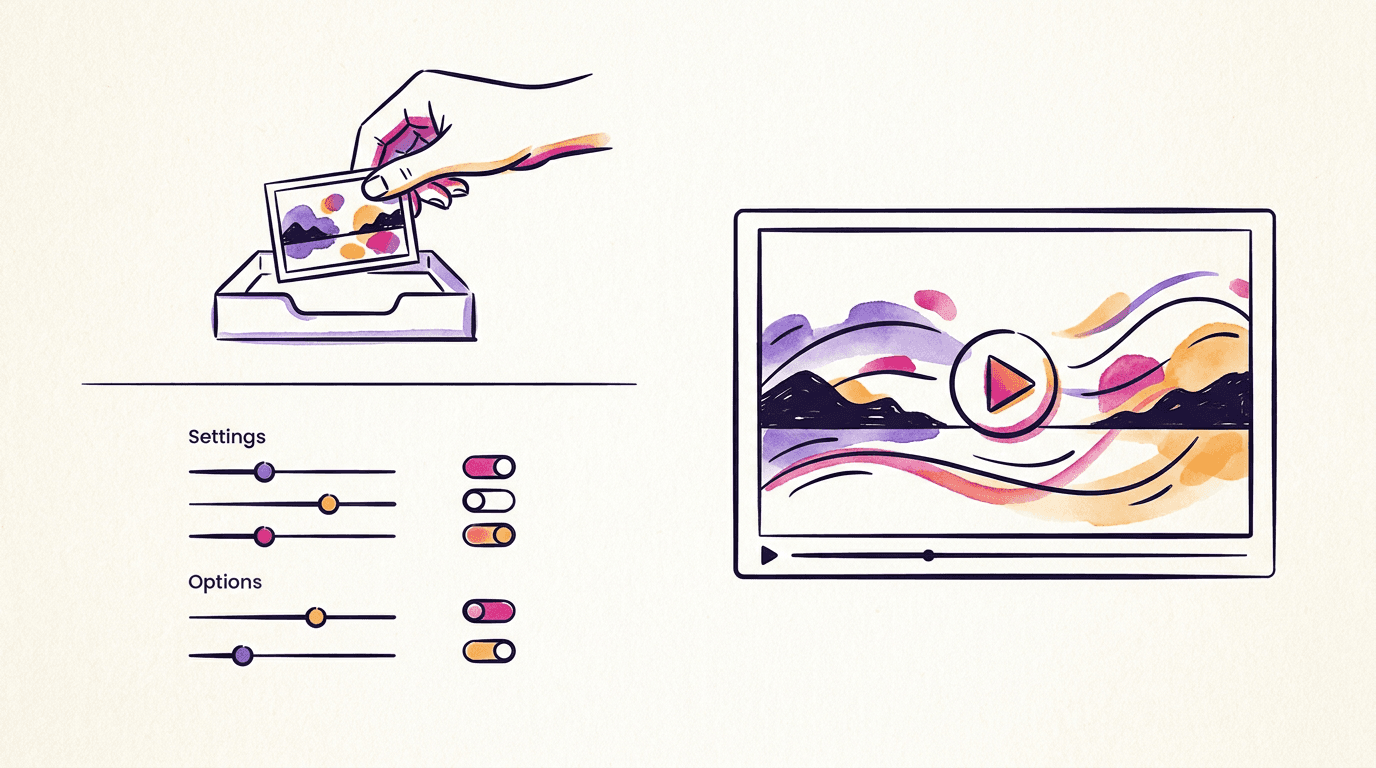
- Alihkan generator ke mode video dan pilih model Anda. Untuk percobaan pertama, Veo 3.1 Lite seharga $0.10 adalah pilihan hemat untuk belajar.
- Unggah foto Anda sebagai frame pertama. Formatnya bisa JPG atau PNG. Foto akan otomatis dipotong menyesuaikan aspek rasio video, jadi periksa bagian pinggir gambar sebelum mulai memproses.
- Pilih rasio 16:9 atau 9:16. Format vertikal sangat cocok untuk TikTok dan Reels; model AI kami mampu menangani orientasi potret dengan sangat baik.
- Tulis motion prompt (panduan gerak, dibahas di bagian berikutnya). Anda juga bisa menambahkan prompt negatif hingga 1.000 karakter untuk elemen yang ingin dihindari.
- Tentukan durasi dan apakah Anda ingin menyertakan audio. Keduanya adalah pengaturan yang presisi pada Veo; pada Omni Flash Anda dapat memilih durasi apa pun dari 3 hingga 10 detik dan audio selalu aktif. Wan 3.0 bisa sampai 30 detik dengan soundtrack gratis yang bisa dimatikan, dan Grok menerima durasi apa pun dari 4 hingga 15 detik dan selalu bicara.
- Klik Generate. Proses render video biasanya memakan waktu 2–5 menit. Anda boleh menutup tab browser Anda; hasilnya akan tersimpan aman di riwayat akun selama 30 hari.
Saldo Anda hanya akan terpotong jika video berhasil dibuat. Jika render gagal, saldo akan otomatis dikembalikan—ini sangat penting karena pembuatan video biasanya membutuhkan beberapa kali percobaan (iterasi) dibanding gambar statis.
Bagaimana cara menulis motion prompt untuk mengubah foto menjadi video?
Aturan pertama: jelaskan gerakannya, bukan pemandangannya. Isi pemandangan tersebut sudah terbaca dari foto Anda. Menulis prompt seperti "A woman in a red coat stands on a bridge" hanya akan membuang kata-kata untuk informasi yang sudah diketahui model. Sebaliknya, prompt "She turns toward the camera and smiles as wind lifts her hair, slow dolly-in" memiliki panjang karakter yang sama tetapi memberikan instruksi gerakan yang sangat jelas.
Istilah pergerakan kamera sangat efektif pada model Veo. Istilah seperti dolly in, orbit, handheld, static tripod shot, atau slow pan left sangat dianjurkan. Model-model ini dilatih menggunakan deskripsi rekaman film nyata, sehingga mereka merespons istilah sinematik jauh lebih baik daripada frasa abstrak seperti "make it dynamic". Sebaiknya hindari kata "dynamic" sama sekali—tidak ada definisi pasti tentang itu, bahkan bagi model AI sekalipun.
Satu pelajaran berharga (dan cukup mahal) yang kami dapat saat membuat klip demo untuk blog ini: model AI cenderung mempertahankan apa pun kondisi yang sudah terjadi di frame pertama, dan diam-diam mengabaikan tindakan yang dijadwalkan mulai di tengah video. Kami pernah meminta Omni Flash untuk membalik panekuk dengan instruksi "around the middle of the clip" (di sekitar tengah klip) dan hasilnya adalah video panekuk diam selama sepuluh detik penuh. Kami mencobanya tiga kali berturut-turut—artinya melayang tiga dolar sia-sia. Begitu kami menulis aksinya sebagai sesuatu yang sudah berjalan sejak awal, masalahnya langsung beres pada percobaan pertama. Jadi: prompt "syrup is pouring onto the stack" jauh lebih bagus dibanding "syrup starts pouring after two seconds". Untuk mengubah foto ke video, pilihlah foto awal di mana aksi yang Anda inginkan masuk akal jika sedang berlangsung.
Beberapa pola prompt yang terbukti selalu berhasil:
- Potret Wajah: "subtle breathing, a slow blink, then a small smile; camera locked" membuat wajah tampak hidup tanpa distorsi aneh (uncanny warp) yang sering dipicu gerakan besar.
- Produk: "slow 180-degree orbit around the object, studio lighting stays constant" adalah andalan terbaik. Pastikan latar belakang foto asli Anda cukup simpel.
- Pemandangan: Sebutkan elemen apa saja yang bergerak (misalnya "clouds drift right, grass sways, light shifts warmer"). Jika tidak, model AI hanya akan memberikan efek zoom kaku yang membosankan (nervous-zoom).
Loop, frame terakhir, dan video berdurasi 148 detik
Model Veo 3.1 dapat menerima frame terakhir opsional di samping frame pertama, begitu juga Omni 1.1 dan Wan 3.0. Berikan dua foto berbeda ke sebuah model, dan model AI akan merender transisi mulus di antaranya—cara yang pas untuk mengubah foto pemandangan siang menjadi malam, atau sketsa kasar menjadi produk jadi. Jika Anda memasukkan foto yang sama untuk awal dan akhir, Anda akan mendapatkan klip yang berakhir persis di titik mulainya: sebuah video loop sempurna yang sangat cocok untuk latar belakang situs web atau postingan ala cinemagraph. Ini adalah fitur favorit saya yang sayangnya jarang dimanfaatkan orang.
Fitur perpanjangan (extension) adalah trik andalan Veo lainnya. Klip video yang sudah jadi bisa diperpanjang selama 7 detik berikutnya menggunakan prompt baru, dan rantai perpanjangan ini bisa terus berjalan hingga total durasi 148 detik dengan kontinuitas visual yang utuh (hanya didukung Veo 3.1 dan Fast; Lite tidak memilikinya). Membuat rangkaian video panjang dari satu foto awal adalah metode pembuatan video tanpa papan cerita (storyboard-free) paling praktis yang ditawarkan teknologi API saat ini. Namun perlu diingat, biayanya akan terus berlipat, jadi hitung matang-matang anggaran Anda sebelum terlanjur menyukai ide ini. Kalau 30 detik sudah cukup, Wan 3.0 merendernya dalam satu take dari foto Anda, tanpa sambungan dan tanpa kontinuitas yang bergeser, seharga $1.50 di 480p atau $3.00 di 720p.
Omni Flash kini juga punya fitur perpanjangannya sendiri: setiap langkah menambah 3 hingga 10 detik ke klip terakhir, bisa dirantai hingga total sekitar 40 detik, plafon yang lebih rendah dibanding 148 detik milik Veo. Selain itu, ia tetap menyediakan pengeditan berbasis percakapan: Anda cukup mendeskripsikan perubahan pada klip yang sudah jadi (misalnya, "make it dusk, keep everything else the same") dan bayar lagi sesuai durasi detikannya — ini juga menerima video yang tidak dihasilkannya, termasuk unggahan Anda sendiri, dan mengembalikannya dengan durasi yang sama. Filosofi yang sangat berbeda. Mengedit berfungsi untuk menyempurnakan satu momen, sedangkan perpanjangan berfungsi memperluas linimasa.
FAQ
Apakah saya bisa mengubah foto menjadi video secara gratis?
Hampir sepenuhnya gratis. Akun baru BananaBanana langsung dilengkapi dengan saldo awal $0.20 tanpa perlu memasukkan kartu kredit, yang cukup untuk membuat dua klip video tanpa suara berdurasi 4 detik menggunakan model Veo 3.1 Lite. Setelah itu, skema yang berlaku adalah bayar per klip mulai dari $0.10.
Apa opsi API termurah untuk mengubah foto menjadi video?
Di BananaBanana, jawabannya adalah Veo 3.1 Lite: $0.10 untuk klip 720p tanpa suara berdurasi 4 detik, atau $0.18 jika disertai suara. Biaya ini hanya dikenakan untuk hasil generasi yang sukses, lengkap dengan pengembalian saldo otomatis jika gagal, tanpa perlu langganan bulanan ataupun menyiapkan Google Cloud.
Apakah video yang dihasilkan bisa menyertakan suara?
Ya. Model-model Veo 3.1 memiliki tombol pilihan audio (untuk memproses dialog, efek suara, dan suasana latar yang Anda tulis di prompt), Gemini Omni Flash selalu menghasilkan audio secara otomatis, yang sudah termasuk dalam harga per detiknya ($0.03 di 360p hingga $0.30 di 4K), Wan 3.0 menambahkan soundtrack secara gratis, dan Grok Imagine Video 1.5 mengucapkan dialog yang Anda tulis.
Apakah saya bisa menganimasikan foto vertikal untuk TikTok atau Reels?
Ya, ketujuh model kami mendukung aspek rasio 9:16, dan Grok Imagine Video 1.5 menambahkan 1:1, 3:2, dan 2:3. Unggah foto Anda, pilih opsi 9:16, dan pastikan untuk menyisakan ruang kosong yang cukup di bagian atas foto asli karena gambar Anda akan otomatis terpotong menyesuaikan rasio tersebut.
Berapa durasi maksimal video AI yang dibuat dari foto?
Setiap klip tunggal berdurasi 4–8 detik pada model Veo, 3–10 detik pada Omni Flash, 4–15 pada Grok, dan hingga 30 detik dalam satu take pada Wan 3.0. Klip pada model Veo 3.1 dan Veo 3.1 Fast juga dapat terus diperpanjang dengan penambahan durasi per 7 detik hingga maksimal 148 detik, sambil tetap mempertahankan konsistensi visual dari foto asli Anda, dan Omni 1.1 bisa diperpanjang hingga sekitar 40 detik.